Qwen Image 2.1 vs 3.0:开发者选型避坑指南
Qwen Image 2.1 与 3.0 怎么选?从长指令排版、透明背景、多参考图、开放权重、部署成本与商用许可,给开发者清晰选型建议。
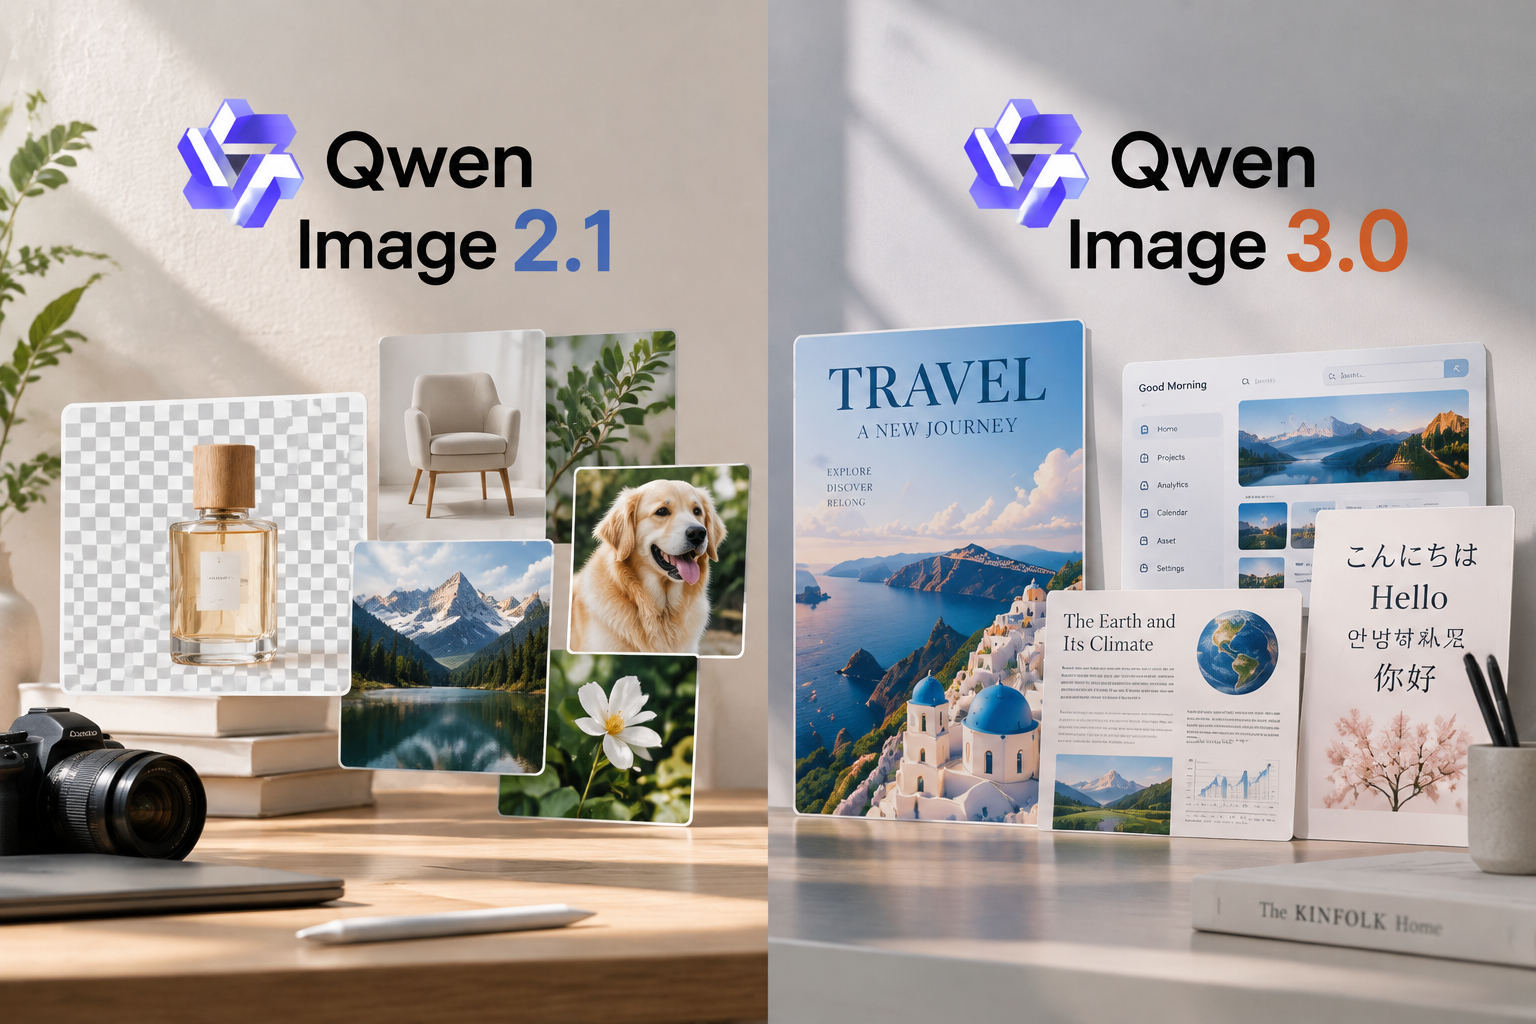
Qwen Image 3.0 和 Qwen Image 2.1,哪个更值得选择?
如果只看版本号,很容易认为 Qwen Image 3.0 是全面升级后的旗舰,而 Qwen Image 2.1 是较早的过渡版本。但实际情况并不是这样:Qwen Image 3.0 于 2026 年 7 月发布,Qwen Image 2.1 则在 9 月推出。后者发布时间更晚,却采用了开放权重的发布路线,并针对参考图编辑、透明图像和推理效率进行了专门设计。
这意味着,两个模型并不是简单的新旧替代关系,而是面向不同使用需求的产品。
对于需要制作海报、信息图、复杂界面和多语言视觉内容的团队,Qwen Image 3.0 的长指令理解和文字渲染能力值得优先评估。对于希望在本地运行模型、处理多张参考图,或者需要透明背景与局部编辑的开发者,Qwen Image 2.1 则有不同的优势。
本文结合阿里云百炼官方模型文档、Qwen 官方开放权重仓库,以及公开评测数据,从模型定位、实际能力、测试结果、价格、部署和 API 接入等方面进行分析,帮助开发者判断是否值得切换模型。
一、先弄清楚:为什么 Qwen Image 2.1 比 3.0 发布得晚?
Qwen Image 系列并不是严格按照版本号递增的单一路线发展。
Qwen Image 3.0 于 2026 年 7 月 21 日发布,随后在阿里云百炼提供对应 API 服务。Qwen Image 2.1 于 2026 年 9 月 20 日发布,定位则更偏向开放权重、推理效率和图像编辑。
两个版本的核心差异,不在于发布时间,而在于产品设计。
Qwen Image 3.0 面向复杂图像生成和编辑任务。它重点强化长提示词理解、小字号文字渲染、多语言排版,以及报纸、试卷、菜单、故事板和软件界面等复杂视觉内容。
Qwen Image 2.1 则提供可下载的模型权重。官方公布的视觉生成模块为 7B 参数,采用 32 层单流 DiT 架构,并支持原生透明图像生成、透明图层编辑,以及最多 10 张参考图的输入。
这里需要区分两个概念:开放权重不等于不受限制的开源商用。 Qwen Image 2.1 使用 Qwen Research License,商业用途需要依据许可证条款另行确认,不能因为模型可以下载,就默认可以直接用于商业产品。
二、Qwen Image 3.0 与 2.1 核心参数对比
先看两款模型在公开规格上的区别。
表格
| 对比维度 | Qwen Image 3.0 / Pro | Qwen Image 2.1 |
|---|---|---|
| 发布时间 | 2026 年 7 月 | 2026 年 9 月 |
| 主要使用方式 | 托管 API | 开放权重,可自行部署 |
| 视觉生成模块参数量 | 官方未披露 | 7B |
| 提示词长度 | 官方宣称最高约 4.5K Token | 官方未明确公布相同口径的 Token 上限 |
| 文字渲染 | 官方宣称支持约 10px 小字 | 支持文字生成与编辑 |
| 语言能力 | 官方宣称原生支持 12 种语言 | 以具体任务和部署配置为准 |
| 最高输出规格 | 最高 2048 × 2048 | 支持最高约 2K 输出,具体比例受配置限制 |
| 参考图输入 | 官方 API 文档列出的输入范围为 1—3 张 | 最多 10 张参考图 |
| 透明背景 | 官方未列为支持能力 | 支持原生 RGBA 透明图像 |
| 局部编辑 | 支持图像编辑,具体参数依 API 而定 | 支持圆圈、涂抹标注和独立蒙版等编辑方式 |
| 模型权重 | 未公开 | 已开放权重 |
| 商业使用 | 遵守托管 API 服务条款 | 需要核对 Qwen Research License 的商业使用限制 |
需要注意,官方公布的能力参数不等于每次生成都能达到同样的效果。例如,10px 是厂商对小字渲染能力的描述,不代表所有 10px 文字在任何尺寸、字体和复杂背景下都能准确呈现。实际结果仍然需要通过测试验证。
三、Qwen Image 3.0 的优势:复杂排版与长指令理解
Qwen Image 3.0 的升级重点,不只是画面更加精细,而是让模型能够处理更复杂的图文组合任务。
1. 更长的提示词,适合复杂视觉需求
阿里云百炼官方资料显示,Qwen Image 3.0 支持最高约 4.5K Token 的输入指令。
相比之下,Qwen Image 2.0 的官方产品介绍强调约 1K Token 的指令处理能力。这里比较的是官方公布的指令规格,不应将其直接理解为所有任务中模型理解能力的固定倍数关系。
长提示词的实际价值,在于开发者可以在一次请求中描述更多视觉约束。
例如,生成一张企业产品信息图时,提示词可能同时包含:主标题、副标题和正文内容,不同区域的布局关系,字体、字号和颜色要求,产品主体与背景之间的关系,图标、标注、图表和装饰元素,以及需要保留或禁止出现的内容。
当任务包含多个区域和大量文字时,如果模型无法充分理解这些要求,就可能出现布局混乱、文字遗漏或元素位置错误。
Qwen Image 3.0 的长指令设计,正是为了更好地处理这类复杂需求。
不过,提示词更长并不意味着结果一定更好。描述之间存在冲突、重复强调不同要求,或者同时提出过多无关约束,都可能影响生成结果。实际使用时,仍应按照主体、布局、文字、风格和限制条件组织提示词。
2. 小字号与多语言排版
图像生成模型长期存在一个实际问题:画面整体看起来不错,但其中的文字无法直接使用。
例如,海报中的标题正确,底部说明却出现错字;菜单中的英文清晰,另一种语言的字符却发生变形;信息图的视觉层级合理,但小字无法辨认。
这些问题会直接增加后期修图成本。
Qwen Image 3.0 官方强调了约 10px 小字渲染和 12 种语言的原生文字呈现能力,应用方向包括信息图、报纸、试卷、菜单和界面设计。
对于需要生成复杂图文的团队,这些能力值得重点评估。
但必须注意,文字渲染与事实准确性是两个不同的指标。即使一张图中的文字清晰可读,也不代表数字、公式、专业术语和图表关系一定正确。
因此,教育、金融和技术文档等场景,仍应保留人工审核或程序化校验。
3. 适合哪些业务?
Qwen Image 3.0 更适合优先测试以下任务:
营销海报与电商视觉。当画面需要同时呈现产品、促销信息、标题和说明文字时,可以测试模型对多层次版面的控制能力。
教育与知识图解。对包含标题、注释、图形和文字说明的内容,长指令有助于在一次请求中描述更完整的结构。但专业事实仍需验证。
软件界面与概念设计。模型可以根据文字描述生成界面视觉方案,用于产品原型讨论和设计探索。生成的图片不等于可以直接运行的前端代码。
多语言内容生产。对于需要适配不同语言市场的菜单、宣传图和活动素材,可以重点测试文字准确率、布局稳定性和语言混排效果。
总体而言,Qwen Image 3.0 的价值,在于将更多视觉规格集中到一次生成任务中,而不是简单追求更高分辨率。
四、Qwen Image 2.1 的优势:多参考图、透明背景与开放权重
如果说 Qwen Image 3.0 更强调复杂内容的生成,那么 Qwen Image 2.1 的设计更突出灵活编辑与部署控制。
1. 最多 10 张参考图,适合复杂编辑任务
Qwen 官方模型卡明确列出了最多 10 张参考图输入能力,并支持使用圆圈、涂抹标注和独立蒙版指定局部编辑区域。
这对于需要保持人物、商品或场景特征的工作流很有意义。
例如,电商团队可能需要将同一件商品放入不同场景。开发者可以提供商品的多角度图片,要求模型更换背景、调整光线或改变构图,同时尽量保留商品本身的结构。
多参考图可以提供更丰富的视觉信息,但也不代表输入越多越好。不同图片之间如果存在颜色、角度、材质或主体结构冲突,模型仍可能难以判断应当遵循哪一份参考。
建议为每张参考图明确职责。例如,一张用于确定主体外观,另一张用于提供背景风格,第三张用于约束构图。这样比简单堆叠大量图片更容易控制结果。
2. 原生 RGBA 透明图像
Qwen Image 2.1 的另一项特点,是支持原生透明图像生成与编辑。
RGBA 图像除了红、绿、蓝三个颜色通道,还包含 Alpha 透明度通道。它可以让主体与背景分离,方便后续合成。
这一能力适用于:商品抠图与产品素材制作,透明背景贴纸和图标,UI 元素和设计素材,需要放入不同背景的品牌视觉资产,透明图层上的局部修改。
传统流程可能需要先生成图片,再通过额外工具去除背景。原生透明输出有机会减少这些处理步骤。
但实际使用时,仍应检查主体边缘、半透明区域、头发和玻璃等复杂材质。透明通道存在,并不意味着每张图都能达到专业抠图的质量要求。
3. 7B 视觉生成模块与本地部署
Qwen Image 2.1 的官方模型卡显示,其视觉生成模块为 7B 参数,采用 32 层单流 DiT 架构,并使用混合粒度注意力和前缀 KV 缓存复用等设计。
这些信息有助于开发者理解模型结构,但不能仅凭 7B 参数就断定它一定可以在普通显卡上顺畅运行。
实际部署还需要考虑文本编码器、模型权重文件、推理精度、显存占用、系统内存、图像分辨率和推理框架。
下面是官方仓库提供的基础加载示例:
import torch
from diffusers import DiffusionPipeline

pipe = DiffusionPipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1",
    dtype=torch.bfloat16,
    device_map="cuda"
)

prompt = (
    "A clean product photograph of a ceramic coffee cup, "
    "soft daylight, neutral background, realistic material details"
)

image = pipe(prompt).images[0]
image.save("qwen-image-2.1.png")
这段代码展示的是官方模型仓库所采用的基本加载方式。运行前,需要根据当前 Diffusers 版本、硬件条件和模型仓库说明准备环境。代码本身不保证在所有设备上都能直接运行。
4. 开放权重不代表可以无条件商用
这一点尤其值得强调。
Qwen Image 2.1 使用 Qwen Research License,而不是直接沿用早期 Qwen Image 的 Apache 2.0 许可。
如果开发者准备将其集成进商业产品、提供收费服务或用于客户项目,需要先阅读许可证全文,并根据实际用途确认授权要求。
开放权重带来的优势主要在于模型可下载、可自行运行和自主可控。
五、Qwen Image 2.1 部署分析:本地运行、工作流集成与 API 服务怎么选?
Qwen Image 2.1 与 Qwen Image 3.0 的另一个重要区别,在于部署方式。3.0 主要通过托管 API 提供服务,而 2.1 已公开模型权重,可以通过本地推理框架运行,也可以集成到现有的图像生成工作流中。
对于开发者来说,开放权重并不意味着下载模型后就能立即投入生产。实际部署还涉及显存、推理速度、依赖版本、任务队列、模型许可证和服务接口等问题。
截至 2026 年 10 月 27 日,Qwen Image 2.1 已支持 Diffusers、ComfyUI、vLLM-Omni、SGLang 和 LightX2V 等方案。官方还发布了 Qwen Image 2.1 Turbo,支持通过 8 步去噪进行图像生成和编辑。
5.1 先理解模型规模:7B 不代表只需要 7B 对应的显存
Qwen Image 2.1 的视觉生成组件采用 7B 参数的单流 Diffusion Transformer(DiT),包含 32 层 Transformer。它还使用 Qwen3-VL 8B 作为文本与条件图像编码器,并配备支持 RGBA 透明通道的 VAE。
这里需要区分视觉生成组件与完整推理流程。7B 指的是生成组件的参数规模,并不代表运行整个模型时只需要为 7B 参数分配显存。文本编码器、VAE、中间激活、输入图像和推理过程中的缓存,也会占用计算资源。
因此,不能仅根据 7B 参数就认定模型适合某一档显卡。官方仓库提供了 CPU Offload、FP8 量化、多 GPU 并行等优化路径,但具体硬件需求仍取决于所选推理框架、精度、图像尺寸和并发任务量。
对于个人开发者,建议先在受控环境中验证单张图片生成,再逐步测试更高分辨率和多参考图编辑。企业部署则应进一步测试显存峰值、单任务耗时、连续运行稳定性及批量任务吞吐量。
5.2 方案一:使用 Diffusers 进行本地推理
如果希望直接通过 Python 调用模型,而不是依赖可视化工作流,Diffusers 是比较直接的选择。
Qwen 官方仓库提供了 QwenImage21Pipeline,用于统一处理文本生成图像和基于图像条件的生成任务。官方列出的基础依赖包括 PyTorch 2.4.0 或更高版本、Transformers 5.17 或更高版本,以及最新的 Diffusers 源码。
安装依赖:
pip install "torch>=2.4.0"
pip install "transformers>=5.17"
pip install git+https://github.com/huggingface/diffusers
pip install accelerate pillow
下面是官方推理流程的简化示例:
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1",
    dtype=torch.bfloat16,
).to("cuda")

prompt = (
    "A minimalist ceramic vase on a wooden table, "
    "soft natural lighting, realistic material details."
)

image = pipe(
    prompt=prompt,
    width=1024,
    height=1024,
    num_inference_steps=40,
).images[0]

image.save("qwen_image_21.png")
运行前需要确认本机具有可用的 CUDA 环境,并且显卡支持所选数据类型。首次加载时还需要下载模型文件,因此应预留足够的磁盘空间和网络带宽。
这段示例使用 1024×1024 输出作为初始测试尺寸。官方还提供了原生 2K 的推荐尺寸,例如 2048×2048 和 1536×2752。实际使用时,可以先确认较小尺寸的推理流程正常,再逐步提高分辨率。
如果显存不足,可以尝试官方提供的模型 CPU Offload:
pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1",
    dtype=torch.bfloat16,
)
pipe.enable_model_cpu_offload()
这种方式可以减少部分模型权重常驻显存的需求,但会增加 CPU 与 GPU 之间的数据传输。它不保证所有硬件都能顺利运行,也不一定适合对响应速度有严格要求的生产服务。
5.3 方案二:ComfyUI 适合可视化创作与复杂工作流
如果团队主要通过节点组织图像生成、编辑和后处理流程,ComfyUI 更适合用于快速搭建工作流。
Qwen Image 2.1 发布时就已提供 ComfyUI 原生支持,并提供兼容的模型权重和文生图、图像编辑工作流。
这种方式的优势在于,开发者可以将提示词处理、参考图输入、模型生成和后期处理组织为可视化节点,而不必从零编写整个流程。
对于电商素材制作,可以先输入商品参考图,再配置编辑指令,生成背景变化或场景变化后的图片。对于需要保持主体一致性的项目,也可以将多张人物或商品图片作为参考素材。
但需要注意,工作流可运行并不代表生成结果一定符合要求。涉及产品标签、商标、文字、透明边缘和商品细节时,仍需要建立验收标准。对于需要重复执行的任务,还应保存工作流版本、模型版本和关键参数,便于后续复现。
5.4 方案三:vLLM-Omni 与 SGLang 适合服务化部署
当应用从个人测试转向批量生产时,问题就不再只是 “能不能生成一张图”,而是如何管理多个请求、减少重复计算并提高 GPU 利用率。
vLLM-Omni 支持 Qwen Image 2.1 的高性能推理,并提供前缀 KV 缓存、CUDA Graph、FP8 量化和张量并行等能力,同时支持请求级与步骤级批处理,以及 CPU Offload 等优化方式。
SGLang-Diffusion 则提供原生图像生成和编辑支持,包括多 GPU 并行、显存卸载及优化内核。对于需要统一管理大量生成任务的服务端应用,这些功能值得纳入评估。
两种框架的适用性仍取决于硬件环境、部署复杂度和任务特征。建议先使用官方示例验证功能,再通过固定提示词和固定图像尺寸开展性能测试。
评测时至少应记录:单张图片的生成耗时,显存峰值与 GPU 利用率,连续任务的成功率,批量任务的平均处理速度,发生显存溢出或服务中断时的恢复情况。
如果需要对外提供图像生成 API,还应在模型服务之外增加请求验证、任务队列、超时控制、结果存储和访问权限管理。推理框架本身并不自动解决全部业务问题。
5.5 Qwen Image 2.1 Turbo:8 步推理是否更适合批量生成?
Qwen Image 2.1 Turbo 沿用相同的 7B 视觉生成架构,通过 8 步去噪支持图像生成与编辑,并由 Diffusers 自动加载对应的推荐采样配置。
相比原始 Qwen Image 2.1 默认的 40 步推理,Turbo 将去噪步数减少到 8 步。这为降低推理时间提供了明确的技术方向,但不能直接据此推断实际速度必然提升某个固定倍数。
实际耗时还会受到显卡、分辨率、模型加载、编码器执行和推理框架等因素影响。更少的去噪步数也不意味着每种提示词都能获得与原版完全相同的图像质量。
建议使用相同的提示词、参考图片和输出尺寸,分别测试原始版本与 Turbo。除了生成时间,还要比较文字准确性、主体一致性、编辑保真度和人工审核通过率。
如果 Turbo 能在满足质量要求的同时显著减少处理时间,就值得优先用于高频任务;如果复杂排版或精细编辑更重要,则应根据实际测试决定是否保留原始版本。
5.6 最容易被忽略的部署问题:许可证与商业使用
Qwen Image 2.1 虽然开放了模型权重,但采用的是 Qwen Research License Agreement,并非 Apache 2.0。该许可证明确规定,默认授权仅适用于非商业目的;商业使用需要向权利方申请单独许可。
这对企业部署尤其重要。
在内部进行研究、评估和技术验证,与将模型用于面向客户的商业产品,并不是同一回事。即使模型已经能够在自己的服务器上运行,也不能因此认为所有商业用途都自动获得授权。
如果计划将 Qwen Image 2.1 用于电商素材生产、付费图像生成服务或商业软件,应在上线前核对完整许可证,并根据自己的使用场景确认所需的商业授权。
此外,开放权重也不等于可以忽略输出内容的审核。涉及人物肖像、商标、受版权保护的素材或专业领域信息时,仍需要遵守适用的法律法规和业务审核要求。
5.7 本地部署还是 API?应该如何决策?
表格
| 业务需求 | 优先评估的方案 | 主要考虑 |
|---|---|---|
| 个人开发与功能验证 | Diffusers | 直接调用模型,便于控制参数 |
| 可视化创作和节点式编辑 | ComfyUI | 便于组织参考图、生成和后处理 |
| 批量任务与服务化部署 | vLLM-Omni 或 SGLang | 关注吞吐量、缓存和资源利用率 |
| 希望减少底层运维 | 托管 API | 无需自行管理完整推理环境 |
| 希望跨模型统一接入 | API 聚合方案 | 核实模型覆盖、接口兼容和计费方式 |
对于不希望自行管理显卡、模型权重和推理框架的团队,可以考虑托管 API。对于需要自主管理运行环境的团队,则可以评估开放权重方案,但必须将基础设施成本和许可证要求一并纳入决策。
如果项目同时使用多个图像模型或其他大模型,也可以评估 KoalaAPI 等统一 API 接入方案,重点确认当前模型目录、接口能力和计费规则是否满足需求。不能仅凭统一接入这一点,就假设所有模型的专有功能都能完整支持。
部署建议: Qwen Image 2.1 的价值不仅在于开放权重,还在于它已经拥有较完整的推理与工作流生态。不过,真正决定部署方案的仍是实际任务、硬件预算、目标吞吐量和授权条件。先完成单任务验证,再测试批量负载与故障恢复,最后才进入生产环境,能够更有效地控制迁移风险。
结语
简单总结两者的选型逻辑:追求复杂图文排版、长指令、多语言小字渲染,优先选择 Qwen Image 3.0;想要本地部署、多参考图编辑、原生透明素材输出,优先选择 Qwen Image 2.1。
二者不存在绝对的优劣,而是面向两类开发场景的互补方案。开发者可以根据素材类型、是否自建算力、商业授权要求,来确定最终选型。

